前陣子我與幾位朋友們聊 vibe coding(氛圍式輔助程式設計)心得時,提到我對於 AI 一下子寫了一大堆 code,但我搞不清它們到底寫了些什麼,感到不太放心。

朋友們開玩笑地回我:那是你程式寫太少了,我們已經多到不想逐行看了,只要測試有過且結果驗證是對的就行了。
“登愣”,我腦中直覺閃過了「風險」二字!
是也沒錯,我們用 Excel 設公式計算數據,也是相信 Excel 一定是對的,沒有人會再人工核算數字正確性。
現今的一般電腦程式已經發展得很成熟了,這麼想沒什麼問題。
但面對 AI,也可以這樣嗎?
我覺得答案是:不能完全這樣想。
傳統程式多半是明確規則驅動的。只要程式邏輯寫對、測試案例覆蓋足夠、輸入條件穩定,系統行為大致可以被預期。
但 AI,特別是生成式 AI,不是單純執行規則,而是在機率、語境、資料與模型行為之間產生結果。
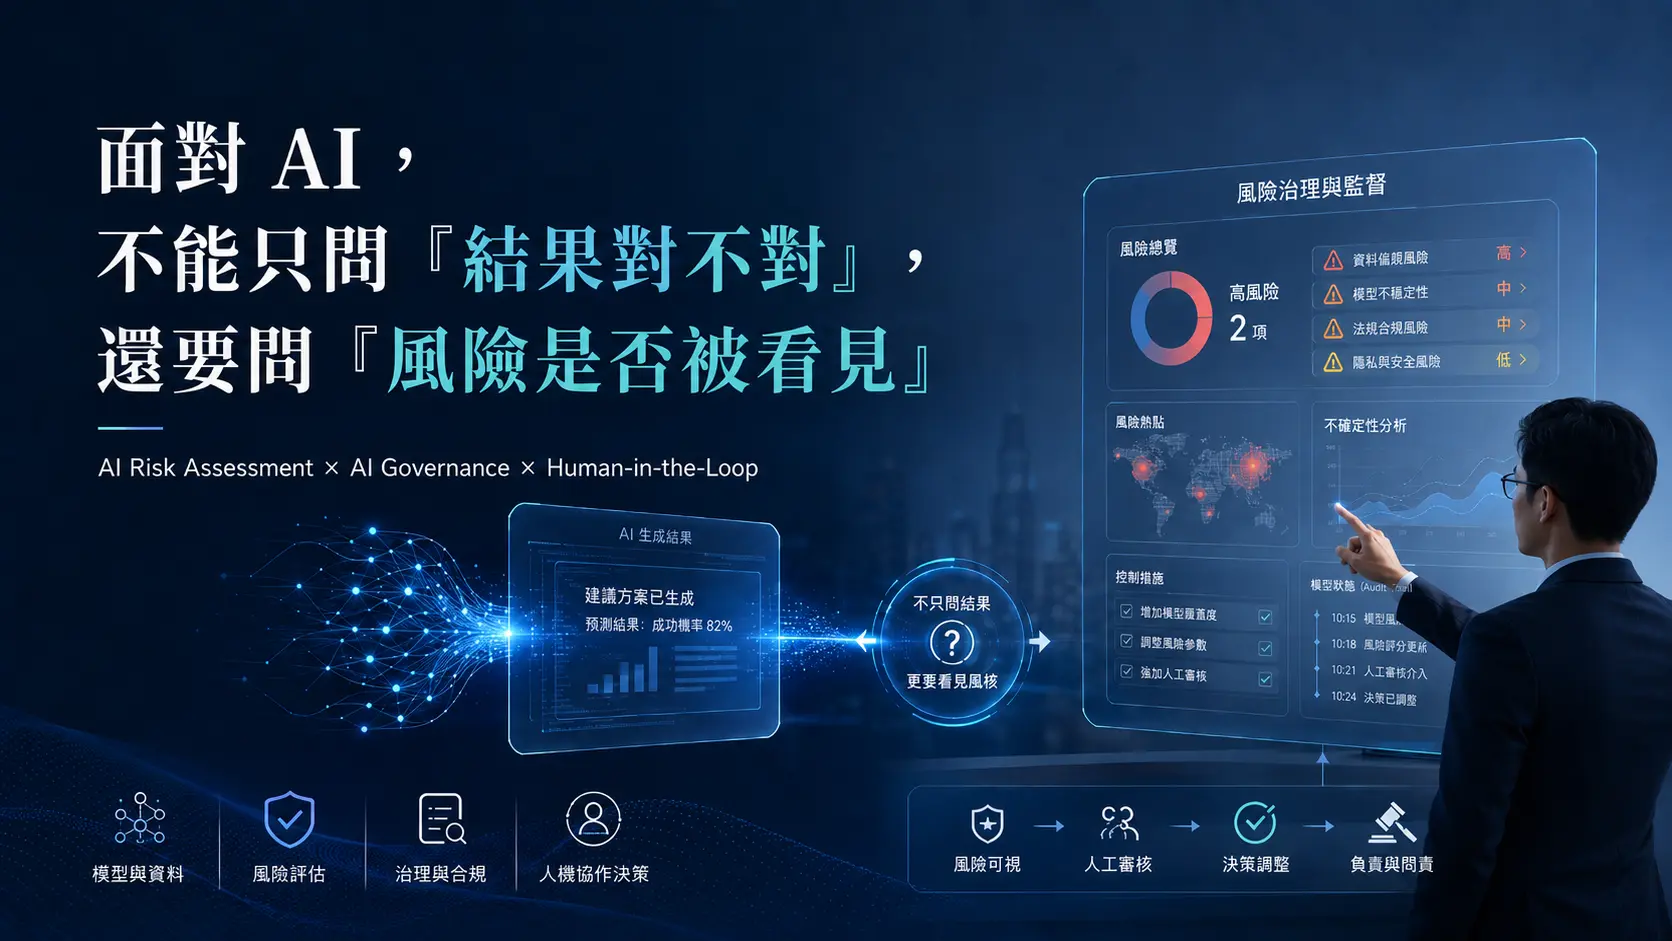
這也是為什麼在 AI 專案中,Human-in-the-Loop(HITL,人類介入流程)不應只是口號,而要被設計成流程中的明確控制點。
問題不只是「人要不要看」,而是「哪些情境一定要人看、誰有權判斷、什麼情況必須暫停或升級」。 
所以我們不能只問:
結果有沒有過測試?
還要問:
  • AI 在什麼情境下會錯?
  • 錯了會影響誰?
  • 誰會發現?
  • 誰能介入?
  • 誰有權限讓它停下來?
這就是 AI 風險評估 (Risk Assessment) 真正要處理的問題。

AI 風險評估不是一般專案風險表的換皮

很多人一聽到 risk assessment,直覺會想到專案管理中的 Risk Register 或 RAID Log。
例如,需求不清、時程延誤、人力不足、預算超支、供應商交付延遲等。
但 AI 專案的風險不只來自專案執行,也來自 AI 本身的行為特性。
AI 的風險評估還要把幾個面向一起納入:
  • 資料
  • 模型
  • 使用情境
  • 治理責任
  • 法規與倫理
  • 人機互動
換句話說,AI 專案不是只要管理如何交付的風險,還要管理「決策風險」、「資料風險」、「模型風險」與「治理風險」。
這也是為什麼 AI 專案即使 PoC 成功,也不代表可以直接進入正式環境。
PoC 證明的是「可不可行」。
風險評估要回答的是「能不能負責任地使用」。

第一個問題:這個 AI 到底在幫誰做什麼決定?

AI 風險評估的第一個問題,不是技術問題,而是情境問題。
也就是:
  • 這個 AI 幫誰做什麼決定?
  • 做錯會造成什麼後果?
如果 AI 只是幫員工整理會議摘要,風險可能相對較低。
但如果 AI 用來協助客戶申訴分類、信用評估、報價建議、履歷篩選、醫療判斷、法遵審查、公部門案件處理或資安事件分級,就不能只用「效率提升」來看待它。
因為這些場景中,AI 的輸出可能影響人的權益、資源分配、金錢損失、合規責任,甚至公共安全。
所以 AI 風險分級的第一個判斷標準,應該是它的「決策影響度」。
AI 若只是提供參考,風險是一種等級;若會影響決策,風險就要提高;若能自動執行決策,風險就必須進入更嚴格的治理。

第二個問題:AI 使用了什麼資料?

很多 AI 風險,表面看起來是模型問題,實際上是資料問題。
例如:資料來源是否合法?是否含有個資、客戶資料、營業秘密或敏感資訊?是否取得同意?資料品質是否完整?是否有偏差?是否已經過時?是否會隨時間失真?
在傳統系統中,資料錯誤通常只是造成計算錯誤或報表錯誤。
但在 AI 系統中,資料問題可能被包裝成一個看起來很有說服力的答案。
這正是生成式 AI 最危險的地方之一:它不只可能錯,還可能錯得很像真的!
因此,AI 風險評估一定要問:
  • 這個 AI 的輸入資料是否可信?
  • 它引用的知識來源是否可追蹤?
  • 它是否可能把敏感資料帶到不該出現的地方?
  • 它是否可能因資料偏差而產生不公平結果?
資料治理不是 AI 專案的配角,而是 AI 風險管理的核心。

第三個問題:模型本身有什麼風險?

很多人在評估 AI 時,第一個想到的是準確率。
準確率當然重要,但它不是全部。
AI 模型還有許多傳統系統比較少見的風險,例如:
  • 幻覺
  • 偏誤
  • 輸出不穩定
  • 可解釋性不足
  • 模型漂移
  • 對 prompt injection 的脆弱性
  • 面對極端情境時失效
  • 產出不當內容
  • 引用錯誤來源
  • 洩漏敏感資訊
這些問題無法單靠「測試有過」就完全解決。
因為 AI 的輸出會受到 prompt、context、資料來源、模型版本、參數設定與使用者輸入影響。
也就是說,今天測試通過,不代表明天在另一個語境、另一批資料、另一個模型版本下仍然安全。
這也是為什麼 AI 系統需要持續監控,而不是一次性驗收。

第四個問題:誰負責監控?誰有權暫停?

AI 治理最容易被忽略的,不是技術控制,而是責任歸屬。
很多企業導入 AI 時會說:「這是 IT 部門負責。」
但業務部門會說:「這是業務流程的一部分。」
資安部門會說:「我們只負責安全規範。」
法遵部門會說:「我們需要看到使用情境。」
最後就會出現一種很危險的狀況:
  • 每個人都有一部分責任,但沒有人擁有完整責任。
所以 AI 風險評估不能只列風險,還要建立責任矩陣。
至少要回答:
  • 誰是 AI Use Case Owner?
  • 誰是 Data Owner?
  • 誰是 Model / System Owner?
  • 誰負責監控與人工覆核?
  • 誰有權暫停 AI?
  • 發生事故時誰負責通報與處理?
如果這些問題沒有先定義清楚,出事時通常不是沒人做事,而是大家都以為別人會做。

第五個問題:哪些決策可以交給 AI?哪些不能?

AI 導入最需要的,不只是風險清單,而是決策風險矩陣,也就是 decision authority matrix。
它要定義:
  • 哪些事情 AI 可以自動完成?
  • 哪些事情 AI 只能提供建議?
  • 哪些事情一定要人工核准?
  • 哪些情況必須升級處理?
  • 哪些輸出屬於不可接受結果?
例如,客服 AI 可以自動回答一般問題,但若涉及退款、法律責任或客訴升級,就必須轉人工。
AI coding assistant 可以產生程式碼,但若涉及安全驗證、權限控管、資料庫操作或金流邏輯,就必須經過更嚴格的 code review。
AI 文件助理可以摘要內部文件,但若涉及個資、合約、法遵或董事會資料,就必須有資料分類與權限控管。
這才是 AI 治理真正落地的地方。不是一句「AI 產出僅供參考」就結束,而是要明確定義 AI 的邊界、權限與升級機制。

第六個問題:AI 上線後要看哪些風險指標?

AI 系統不像傳統系統一樣,只要功能沒有壞,就大致可以穩定運作。
AI 需要持續看風險指標,例如:
  • 錯誤率
  • 幻覺率
  • 人工覆核退件率
  • 使用者申訴數
  • 異常輸出比例
  • 敏感資料事件數
  • 模型漂移指標
  • 不同群體之間的誤差差異
  • AI 建議被人工推翻的比例
這些指標不是單純 KPI,而是 AI 治理的早期預警系統。
如果只看「使用次數增加」或「處理時間縮短」,企業很容易高估 AI 的價值,卻低估 AI 正在累積的風險。

如何設計一份簡化版 AI 風險評估表

如果要快速落地,我會建議先用一份簡單表單開始,不要一開始就做成厚厚一本制度文件。
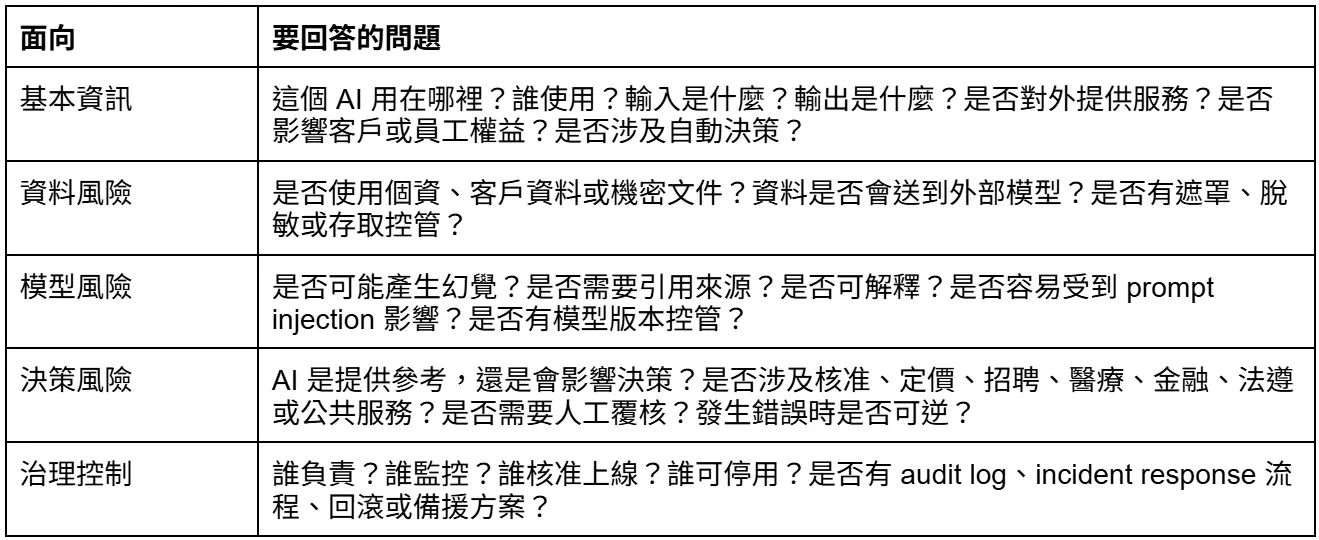
每個 AI use case 至少要從五個面向回答問題:
簡化版AI風險 估表

而這些 AI 風險評估最實用的做法,就是把它併入既有的專案治理流程。

如果公司已經有 Risk Register 或 RAID Log,就不要另外做一套完全孤立的 AI 風險文件。

把 AI 專屬風險項目加入既有風險管理機制,AI risk 才會真的被專案團隊與其他風險一併追蹤,而不是只在審查時出現一次。

這會是 AI 時代專案經理很重要的新能力。

高風險 AI 的簡單判準

如何判斷某項 AI 功能的風險很高?可以用底下這個等式: 

高風險 AI = 高影響決策 + 高敏感資料 + 低可解釋性 + 低人工介入能力。

只要這四項同時偏高,就不應該只把它當成一般 IT 專案處理。

例如:AI 使用大量個資,協助做金融授信判斷,而且模型依據不透明,人工也沒有即時介入能力。

這就不是單純的「導入 AI 提升效率」,而是一個需要嚴格治理的高風險 AI 系統。

相反地,如果 AI 只是幫員工整理非敏感會議摘要,而且人工會自行判斷是否採用,風險等級相對較低。

AI 治理的重點不是把所有 AI 都管到不能動,而是讓不同風險等級的 AI,接受不同程度的治理。

從 AI 風險評估 接到 AI 治理 SOP

那風險評估完之後,要怎麼管理這些風險?這就是 AI 治理 SOP 的價值。

企業至少需要幾個基本制度:

第一,AI 使用管理辦法:明確規範哪些 AI 工具可以用、哪些資料不能輸入、哪些情境需要申請、哪些行為被禁止。

第二,AI 導入評估流程:所有 AI use case 在導入前,都要完成風險分級、資料評估、資安評估、法遵評估與供應商評估。

第三,AI 事故處理流程:當 AI 發生幻覺、錯誤建議、個資外洩、prompt injection、RAG 文件外洩或自動化動作失控時,組織要知道如何通報、暫停、修正與復原。

第四,AI 變更管理流程:模型版本更新、prompt template 變更、RAG 知識庫更新、資料來源改變,都可能影響 AI 行為。這些變更都應該有測試、驗證、紀錄與核准。

第五,AI 稽核軌跡:要能證明這個 AI 系統什麼時候被評估、誰核准、用了什麼模型與資料、輸出了什麼結果、誰覆核,以及發生問題時怎麼處理。

沒有稽核軌跡,就很難有真正的 AI accountability。

真正的問題不是 AI 會不會犯錯,而是知不知道它何時犯錯

AI 的價值在於提高效率、擴大能力、加速決策。

但 AI 的風險也在於,它可能讓錯誤以更快的速度、更大的規模、更有說服力的形式發生。

所以,面對 AI,我們不能只問:

  • 它能不能做?

我們還要問:

  • 它做錯時,我們能不能知道?
  • 能不能介入?
  • 能不能停下來?
  • 能不能負責?

這才是 AI Risk Assessment 的核心。

不是為了阻礙 AI 導入,而是為了讓 AI 導入可以走得更遠、更穩,也更值得信任。