前陣子 OpenAI 釋出了最新的圖片生成模型 gpt-image-2,其生成效果比先前的繪圖模型明顯提升很在使用者間引起了討論。而這個月,2026年5月12日,OpenAI 也正式將已出到第三代的 DALL-E 系列 API 全數下架,並在官網上建議使用者改用 gpt-image-2、gpt-image-1-mini 或 gpt-image-1。
圖片溯源、內容可信
- 誰產生的
- 使用什麼工具產生
- 何時產生
- 是否為 AI 生成
- 是否曾經被 AI 編修
C2PA 與 SynthID 溯源技術
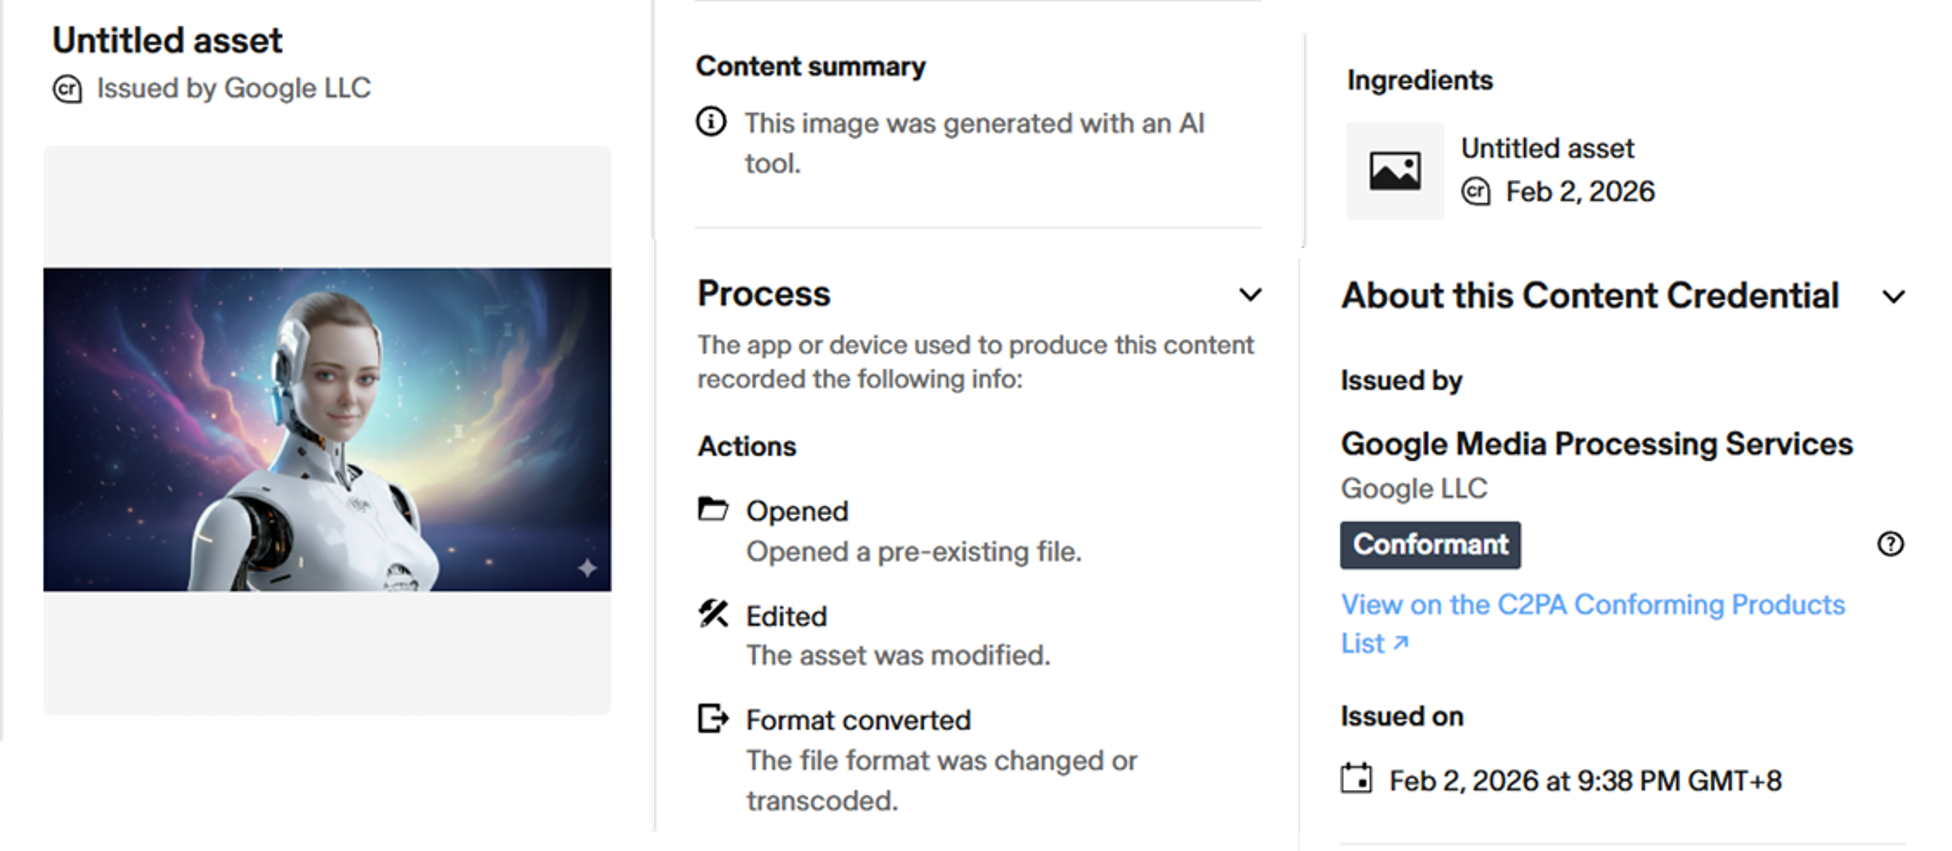
而這也的確符合實際情況。因為這張圖中的女性機器人與背景,其實是由我在不同時間生成的兩張圖片,再於 2026 年 2 月 2 日透過 Gemini 合成的結果。
雖然目前這些資訊仍無法直接追溯最原始兩張圖片的完整生成歷史,但至少可以知道,這張圖片是由 AI 生成,並且是從既有圖片修改而來。因為驗證資訊中明確顯示:
- Opened a pre-existing file
- Asset was modified
那麼,C2PA 驗證網站又是如何知道這張圖片是由 Google AI 生成且曾被修改過?
其實除了 C2PA metadata 外,這張圖片中還包含另一項隱藏資訊:SynthID。
SynthID 是一種嵌入在圖片編碼中的不可見數位浮水印技術。
C2PA(內容溯源與真實性聯盟)是由 Adobe、Microsoft、OpenAI、Google、BBC、Intel、ARM、Truepic 等多家科技公司與媒體組織共同推動的「可驗證內容來源標準(Content Provenance Standard)」。
其目的包括:
- 記錄內容來源(provenance)
- 驗證內容是否被修改
- 標示 AI 生成或 AI 編修資訊
- 建立可驗證的內容信任鏈
使用者只要使用支援 C2PA 標準的平台或工具(包含相機或攝影器材)產生圖片或影片,就能產生可被溯源的媒體檔案。事實上,使用者也可以透過開源工具 c2patool,為自己的圖片加上 C2PA 資訊,讓自己的作品同樣具備內容溯源能力。
不過,C2PA 也有其限制。因為 metadata 是可以被修改或刪除的,而許多社群平台在圖片上傳後,也會自動移除 metadata。此外,一旦圖片再次被修改,原有的 metadata 也可能因此改變。
這時,另一項技術 SynthID 就派上用場了。
SynthID 是 Google DeepMind 推出的不可見浮水印技術,目前主要嵌入於 Google 自家的生成式 AI 產品與模型輸出中,例如圖片、音訊、文字與影片。
SynthID 的名稱來自:
- Synthetic(合成)
- Identity(識別)
如果想知道某張圖片是否含有 SynthID,目前甚至可以直接將圖片丟給 Gemini 詢問。
SynthID 與 C2PA 最大的不同在於:
C2PA 偏向 metadata 與內容履歷的概念,而 SynthID 則是將浮水印資訊直接嵌入圖片本身。
因此,即使圖片經過修改、壓縮、裁切,仍可能保留部分可供辨識的 SynthID 訊號。這也某種程度上解決了 C2PA metadata 在內容遭修改後容易遺失的問題。
目前 SynthID 最大的限制在於,只有 Google 以及部分與 Google 合作的媒體業者能將 SynthID 嵌入圖片中,因此它目前仍無法全面普及。
不過,從 Google 首次公開 SynthID 至今也不過兩年多,未來其普及化仍相當值得期待。
結語 – 從內容生成到內容可信
回到本文真正想傳達的重點:
下一世代的 AI 系統,未來被評價的標準,將不再只是它們生成內容時有多聰明、品質有多高。
我們更會關注:
這些內容是否可被透明地驗證
- 是否能被追溯
- 是否能被治理
- 是否值得信任
生成式 AI 的未來,不只是生成能力。
更是內容溯源(Provenance)。